سایت بالا اومده، صفحهها توی مرورگر درست باز میشن، ولی توی گوگل خبری ازشون نیست. معمولاً اولین توصیه اینه که «محتوای بیشتر بنویس» یا «کلمهی کلیدی اضافه کن». ولی خیلی وقتها مشکل اصلاً به محتوا نمیرسه: گوگل یا صفحه رو ندیده، یا نتونسته بخونه، یا خود سایت بهش گفته ایندکسش نکن.
این پست از دید یه توسعهدهنده به این مشکل نگاه میکنه: کجای مسیر خراب شده و چطور با Search Console و چند دستور ساده پیداش کنیم. مثالها هم واقعیان؛ از گزارشهای Search Console همین سایت، که توی اولین بررسی تقریباً نصف آدرسهاش ایندکس نشده بود.
اول: مشکل کجای مسیره؟
یه صفحه قبل از اینکه توی نتایج بیاد، از پنج مرحله رد میشه و هر کدوم میتونه جداگانه خراب بشه:
- کشف (Discovery): گوگل باید بدونه این آدرس وجود داره؛ از لینکهای داخلی، لینکهای سایتهای دیگه یا sitemap.
- خزش (Crawl): Googlebot درخواست میفرسته و پاسخ میگیره. اینجا robots.txt، خطای سرور و ریدایرکتها اثر دارن.
- رندر (Render): گوگل صفحه رو مثل یه مرورگر اجرا میکنه تا محتوای واقعی رو ببینه. اگه CSS یا جاوااسکریپت بسته باشه، چیزی که میبینه با چیزی که کاربر میبینه فرق داره.
- ایندکس (Index): گوگل تصمیم میگیره این صفحه رو نگه داره یا نه؛ تگ
noindex، canonical و تکراری بودن محتوا اینجا تعیینکنندهان. - رتبه (Ranking): تازه اینجا محتوا، کلمهی کلیدی و اعتبار سایت اهمیت پیدا میکنن.
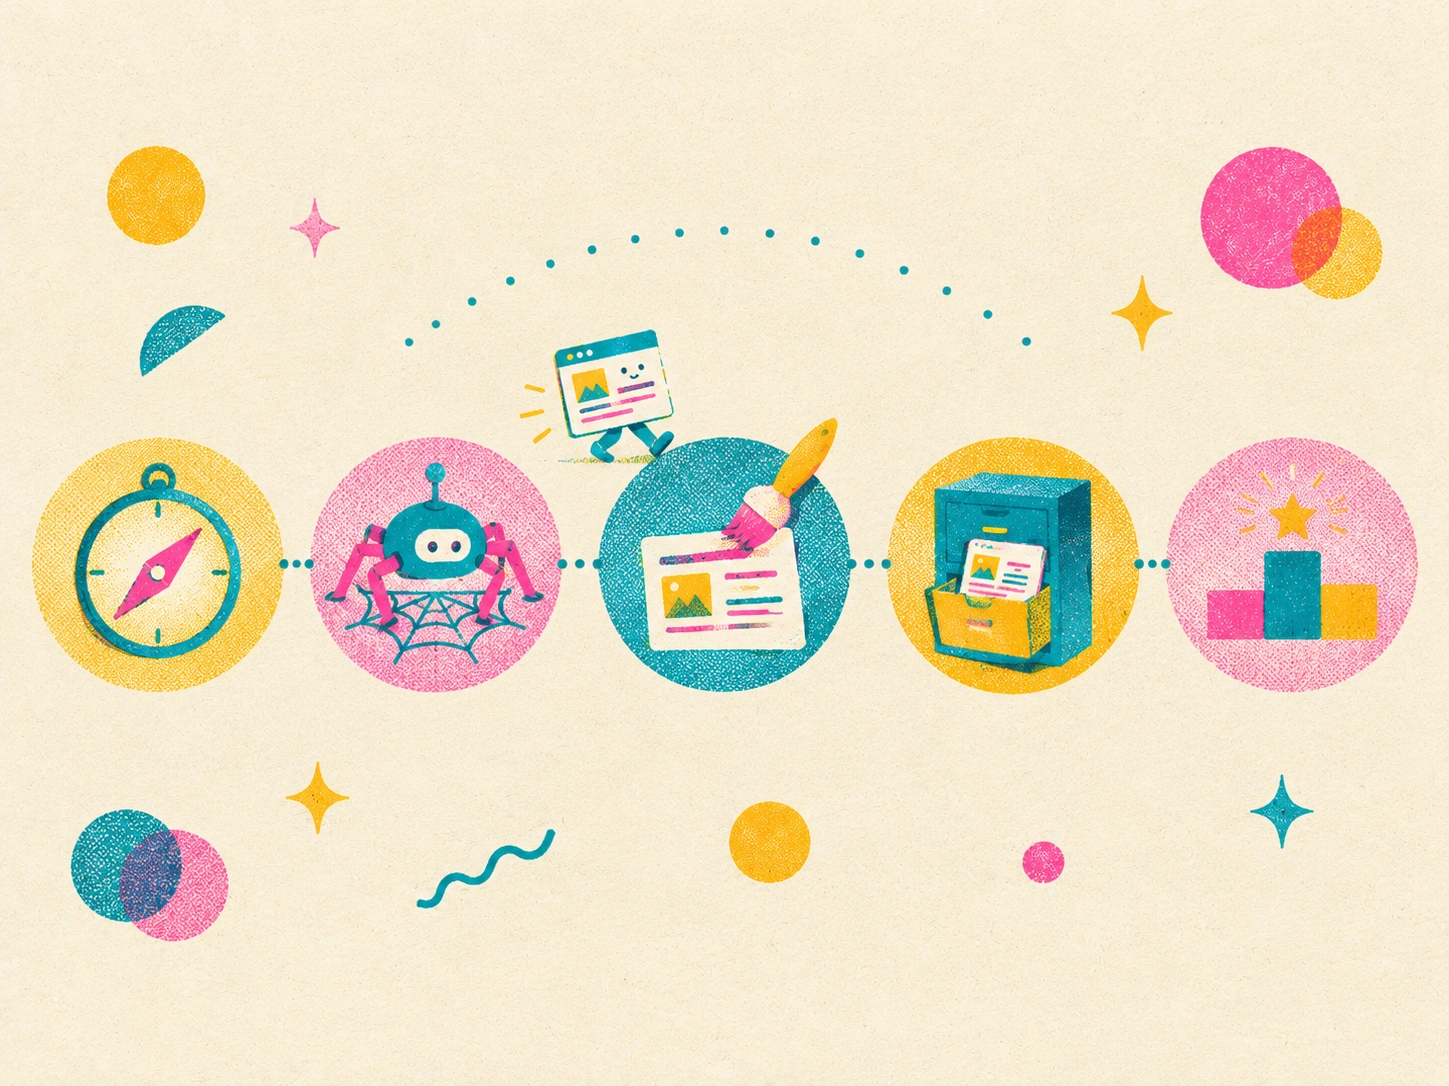
بیشتر توصیههای رایج سئو دربارهی مرحلهی پنجمه. ولی اگه صفحه توی مرحلهی دوم گیر کرده باشه، بهترین محتوای دنیا هم دیده نمیشه. پس اول باید بفهمی کجا گیر کرده.
ابزار اصلی: گزارش Pages در Search Console
جستوجوی site:example.com فقط یه تخمین سرانگشتیه و دلیل رو نمیگه. منبع دقیق، بخش Indexing › Pages در Google Search Consoleه که برای هر آدرس ایندکسنشده دلیلش رو هم مینویسه. برای یه آدرس مشخص هم URL Inspection نشون میده گوگل آخرین بار کی اومده، چه پاسخی گرفته و چه canonicalای انتخاب کرده.
اینها رایجترین دلیلها و معنی واقعیشونه:
| پیام در Search Console | یعنی چه | جدی است؟ |
|---|---|---|
| Page with redirect | آدرسی که به جای دیگه ریدایرکت میشه | معمولاً نه؛ مقصد ایندکس میشه |
| Not found (404) | آدرس دیگه وجود نداره | بستگی داره کسی بهش لینک داده یا نه |
| Blocked by robots.txt | خودت جلوی خزش رو گرفتی | اگه ناخواسته باشه، بله |
| Excluded by 'noindex' tag | خود صفحه گفته ایندکسم نکن | اگه ناخواسته باشه، خیلی |
| Duplicate without user-selected canonical | گوگل چند نسخهی مشابه دیده و خودش یکی رو انتخاب کرده | باید canonical رو درست کنی |
| Discovered – currently not indexed | آدرس رو میشناسه ولی هنوز سراغش نیومده | روی سایت تازه عادیه، ولی نشونهی اولویت پایینه |
| Crawled – currently not indexed | اومده، خونده، ولی تصمیم گرفته نگهش نداره | معمولاً مشکل کیفیت یا تکراری بودن |
| Server error (5xx) | وقتی گوگل اومده سرور خطا داده | بله؛ اگه تکرار بشه، گوگل کمتر میاد |
حالا علتهای فنی پشت این پیامها، به ترتیب مسیر.
۱. robots.txt بیش از حد میبنده
robots.txt به خزندهها میگه کجا نرن. مشکل وقتی پیش میاد که یه خط ظاهراً بیخطر چیزی رو ببنده که گوگل برای رندر لازم داره.
توی همین سایت، robots.txt یه خط Disallow: /_next/ داشت؛ به این نیت که فایلهای داخلی Next.js توی نتایج نیاد. ولی CSS، جاوااسکریپت و فونتهای سایت دقیقاً از همین مسیر لود میشن. Search Console فونت سایت رو با پیام «Blocked by robots.txt» نشون داد؛ یعنی گوگل صفحهها رو بدون منابعی که برای ساختنشون لازم بود میدید. راهحل یه خط بود: حذف همون Disallow.
قانون کلی: هیچوقت مسیر فایلهای استاتیک (CSS، JS، فونت، تصویر) رو توی robots.txt نبند. robots.txt جای مخفی کردن صفحه هم نیست؛ صفحهای که بسته شده ولی لینک داره ممکنه بدون محتوا توی نتایج بیاد. برای بیرون نگه داشتن یه صفحه از noindex استفاده کن.
۲. noindexی که جا مونده
رایجترین و بیصداترین علت: سایت توی محیط تست با noindex ساخته شده که گوگل نسخهی نیمهکاره رو نبینه، و همون تنظیم به سرور اصلی رفته. صفحه کاملاً سالمه، فقط به گوگل گفته «منو نگه ندار».
noindex دو جا میتونه باشه و باید هر دو رو چک کنی:
# در HTML
curl -s https://example.com/page | grep -i "noindex"
# در هدر HTTP (این یکی توی سورس صفحه دیده نمیشه)
curl -sI https://example.com/page | grep -i "x-robots-tag"
دومی رو معمولاً یادمون میره: تنظیمات سرور (مثلاً nginx) یا یه افزونه میتونه هدر X-Robots-Tag: noindex رو به همهی پاسخها اضافه کنه و توی سورس صفحه هیچ ردی ازش نباشه.
۳. canonical اشتباه و نسخههای تکراری
برای گوگل، example.com/page و example.com/page/ و http://example.com/page و example.com/page?utm_source=x میتونن چهار صفحهی جدا باشن. تگ canonical میگه کدومشون نسخهی اصلیه.
دو اشتباه رایج:
- canonical همهی صفحهها به صفحهی اصلی اشاره میکنه. این معمولاً از یه قالب یا کامپوننت مشترک میاد که آدرس صفحهی جاری رو نمیگیره. نتیجه اینه که از دید گوگل همهی سایت فقط یه صفحهست.
- canonical اصلاً نیست، و گوگل بین نسخههای مختلف خودش یکی رو انتخاب میکنه؛ گاهی نسخهای که تو نمیخوای.
توی گزارش این سایت، یه نسخهی قدیمی با / آخر آدرس با پیام «Duplicate without user-selected canonical» اومده بود؛ یادگار ساختار سایت قبلی. ریدایرکت دائمی آدرسهای با / به نسخهی بدون / و یه canonical درست برای هر صفحه، این دسته رو حل میکنه.
برای سایت دوزبانه، hreflang هم مهمه: هر نسخهی فارسی باید به نسخهی انگلیسیش اشاره کنه و برعکس، وگرنه گوگل ممکنه یکی رو تکراری اون یکی حساب کنه.
۴. محتوایی که فقط با جاوااسکریپت ساخته میشه
اگه صفحه یه HTML تقریباً خالیه و همهی متن بعداً با جاوااسکریپت از API گرفته و ساخته میشه، گوگل باید صفحه رو رندر کنه تا محتوا رو ببینه. گوگل این کار رو میکنه، ولی رندر یه مرحلهی جدا و پرهزینهست که ممکنه با تأخیر انجام بشه، و هر خطای جاوااسکریپت یعنی صفحهی خالی.
تست ساده:
curl -s https://example.com/blog/my-post | grep -c "یک جمله از متن پست"
اگه 0 گرفتی، یعنی متن توی HTML اولیه نیست. برای صفحههایی که باید توی گوگل بیان (مقاله، محصول، نمونهکار)، رندر سمت سرور یا تولید استاتیک (SSR، SSG یا ISR در Next.js) این مشکل رو از ریشه حل میکنه. این سایت هم به همین دلیل صفحههاش رو سمت سرور میسازه و بعد از هر تغییر محتوا دوباره تولیدشون میکنه.
۵. خطای سرور درست وقتی گوگل میاد
سایتی که برای تو باز میشه ممکنه برای Googlebot خطا بده: سرور زیر بار کند میشه، فایروال یا محدودکنندهی نرخ درخواستهای رباتها رو میبنده، یا یه سرویس وابسته از دسترس خارج میشه.
یه نمونه از همین سایت: فرانت (Next.js) دادهها رو از بکاند (Django) از طریق آدرس عمومی سایت میگرفت. یه روز که ارتباط سرور با اینترنت مشکل پیدا کرد، سرور دیگه به آدرس عمومی خودش هم نمیرسید و کل سایت خطای ۵۰۰ داد؛ در حالی که فرانت و بکاند هر دو سالم بودن و روی یه ماشین کنار هم کار میکردن. راهحل این بود که فرانت مستقیم و از مسیر داخلی به بکاند وصل بشه.
خطای گاهبهگاه معمولاً مشکلی ایجاد نمیکنه، ولی اگه گوگل چند بار پشتهم ۵xx بگیره، سرعت خزش رو کم میکنه و صفحهها دیرتر ایندکس میشن. نگاه به لاگ سرور برای درخواستهای Googlebot (یا بخش Settings › Crawl stats در Search Console) نشون میده گوگل دقیقاً چه پاسخی گرفته.
۶. آدرسهای قدیمی و صفحههای حذفشده
وقتی سایت بازطراحی میشه یا ساختار آدرسها عوض میشه، گوگل هنوز آدرسهای قبلی رو میشناسه. اگه این آدرسها ۴۰۴ بدن، هر اعتباری که جمع کرده بودن از بین میره.
توی گزارش این سایت، آدرسهایی مثل /en/index.html از نسخهی استاتیک قدیمی سایت هنوز خزیده میشدن و ۴۰۴ میدادن. جالبتر: یه پست وبلاگ قدیمی که حذف شده بود، هنوز توی نتایج گوگل نمایش میگرفت، حتی برای یه جستوجوی اسپانیایی. یعنی صفحهای که ما فکر میکردیم مهم نیست، تقاضای واقعی داشت. اون پست با همون آدرس قبلی برگشت.
قانون کلی: قبل از حذف یا تغییر آدرس یه صفحه، توی Search Console ببین نمایش داره یا نه. اگه داره، یا همون آدرس رو نگه دار یا با ریدایرکت ۳۰۱ به نزدیکترین صفحهی جایگزین بفرستش.
۷. «Discovered – currently not indexed»: گوگل هنوز نیومده
این پیام یعنی گوگل آدرس رو میشناسه (معمولاً از sitemap) ولی هنوز اولویتی برای خزیدنش قائل نشده. روی سایت تازه یا دامنهای که اعتبار کمی داره، این حالت عادیه. توی اولین بررسی این سایت، بیشترِ این دسته نسخههای انگلیسی صفحهها بودن که گوگل هنوز یک بار هم سراغشون نیومده بود.
کارهایی که واقعاً اثر دارن:
- لینک داخلی: صفحهای که فقط توی sitemap هست و هیچ صفحهی دیگهای بهش لینک نداده، از دید گوگل کماهمیته. از صفحههای اصلی و پستهای مرتبط بهش لینک بده.
- sitemap درست: فقط آدرسهای نهایی و قابل ایندکس (نه ریدایرکت، نه ۴۰۴، نه noindex)، با
lastmodواقعی. - Request indexing در URL Inspection برای صفحههای مهم؛ تعدادش در روز محدوده، پس برای مهمترینها نگهش دار.
- لینک از بیرون: یه لینک از یه پروفایل یا سایت معتبر، اولویت خزش رو بالا میبره.
- IndexNow برای Bing و چند موتور دیگه: با هر انتشار یا تغییر، آدرس رو خودت اعلام میکنی و منتظر خزش نمیمونی. گوگل از IndexNow پشتیبانی نمیکنه، ولی Bing منبع جستوجوی چند دستیار هوش مصنوعی هم هست.
و صبر. روی دامنهی تازه، رسیدن از «Discovered» به «Indexed» ممکنه چند هفته طول بکشه.
چکلیست تشخیص
وقتی یه صفحه توی گوگل نیست، به همین ترتیب جلو برو:
- URL Inspection در Search Console: گوگل این آدرس رو میشناسه؟ آخرین خزش کی بوده؟ چه پیامی داده؟
- کد پاسخ:
curl -sIباید200بده؛ نه ریدایرکت زنجیرهای، نه ۴۰۴، نه ۵xx. - robots.txt: این مسیر یا فایلهای CSS و JS اون بسته نشده باشن.
- noindex: هم در HTML، هم در هدر
X-Robots-Tag. - canonical: به خود همین صفحه اشاره کنه، نه به صفحهی اصلی یا نسخهی دیگه.
- محتوا در HTML اولیه: با
curlیه جمله از متن رو جستوجو کن. - sitemap و لینک داخلی: صفحه توی sitemap باشه و دستکم از یه صفحهی دیگه بهش لینک داده شده باشه.
اگه همهی اینها درست بود و صفحه باز هم ایندکس نشد، تازه وقتشه سراغ محتوا و کیفیت بری.
جمعبندی
«سایتم توی گوگل نیست» یه مشکل نیست؛ اسم مشترک چند مشکل متفاوته که هر کدوم توی یه مرحلهی مسیر رخ میدن. بیشترشون هم مشکل فنیان که یه توسعهدهنده با Search Console و چند دستور curl توی چند دقیقه پیداشون میکنه. تقریباً همهی مشکلهایی که توی این پست گفتم رو روی همین سایت تجربه کردم، و هیچکدومشون با «محتوای بیشتر» حل نمیشد.