
اگه تا حالا خواسته باشی اطلاعات تعداد زیادی صفحهی وب رو جمع کنی، احتمالاً خیلی زود به یه راه ساده رسیدی: «خب، یه اسکرپر مینویسیم.»
از یه نظر هم درست میگی. با پایتون و چند تا ابزار مناسب، میشه اطلاعاتی رو که جمع کردن دستیش ساعتها یا حتی روزها طول میکشه، خیلی سریعتر جمع کرد.
ولی یه سؤال مهمتر هم هست: اصلاً باید برای این کار اسکرپر بسازیم؟
وب اسکرپینگ فقط نوشتن چند خط کد برای گرفتن عنوان و قیمت یه محصول نیست. وقتی پروژه جدی میشه، با تغییر ساختار سایت، درخواستهای زیاد، صفحههای JavaScriptی، خطاهای شبکه، محدودیت دسترسی، دادهی ناقص و هزینهی نگهداری روبهرو میشی.
توی این مقاله از همین زاویه نگاه میکنیم: وب اسکرپینگ چیست، کی واقعاً ارزش داره و قبل از شروع پروژه باید به چه چیزهایی فکر کنی.
وب اسکرپینگ چیست؟
خیلی ساده بخوام بگم، وب اسکرپینگ یعنی استخراج خودکار اطلاعات از صفحههای وب.
فرض کن میخوای قیمت ۱۰ هزار محصول رو از چند صد صفحه جمع کنی. دستی که بخوای انجامش بدی، کلی وقتت رو میگیره. ولی یه برنامه میتونه صفحهها رو بگیره، اطلاعات موردنظر رو از HTML پیدا کنه و آخرش توی فایل، دیتابیس یا یه سیستم دیگه ذخیرهشون کنه.
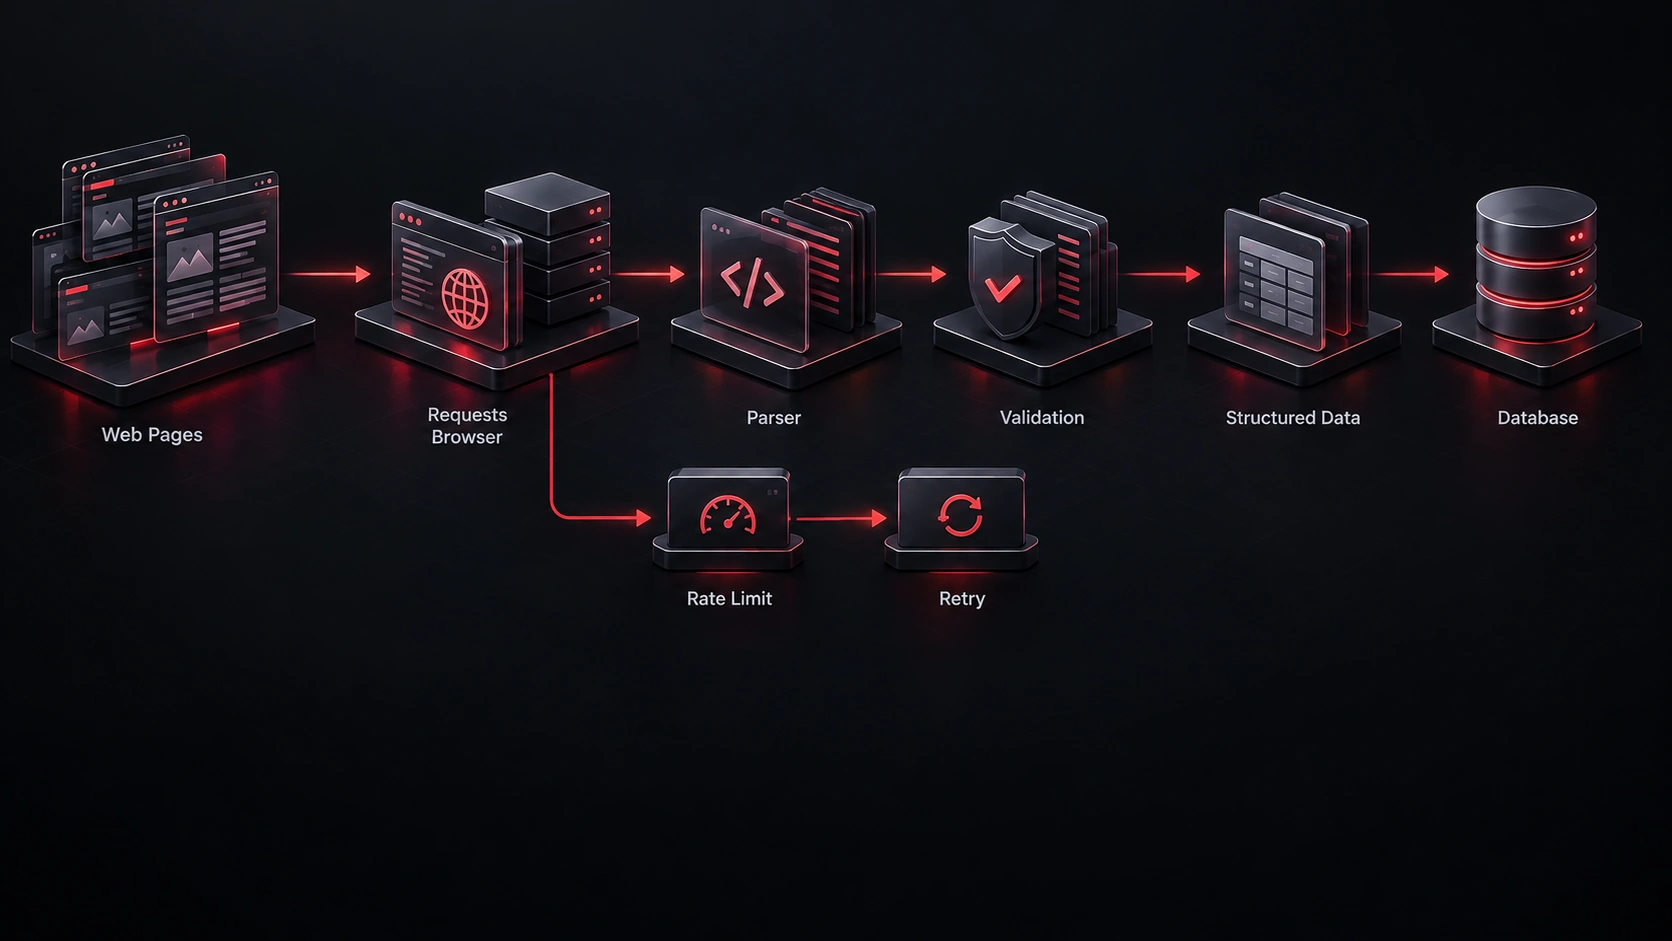
یه جریان ساده میتونه این شکلی باشه:
Website
   ↓
Request
   ↓
HTML / Response
   ↓
Parser
   ↓
Extracted Data
   ↓
Database / CSV / API
برای صفحههای ساده، requests و BeautifulSoup معمولاً نقطهی شروع خوبی هستن:
import requests
from bs4 import BeautifulSoup

url = "https://example.com/products"

response = requests.get(
    url,
    timeout=10,
    headers={
        "User-Agent": "my-scraper/1.0 (+mailto:you@example.com)"
    },
)

response.raise_for_status()

soup = BeautifulSoup(response.text, "html.parser")

for product in soup.select(".product"):
    title = product.select_one(".title")

    if title:
        print(title.get_text(strip=True))
یه نکته دربارهی User-Agent: اینجا عمداً خودمون رو جای مرورگر جا نزدیم. یه اسم مشخص و یه راه تماس یعنی صاحب سایت میدونه درخواستها از کجا میاد و اگه مشکلی بود، میتونه باهات تماس بگیره؛ نه اینکه یهراست مسدودت کنه.
ولی این فقط بخش سادهی ماجراست. اسکرپر واقعی معمولاً باید با خطا، تغییر ساختار، صفحهبندی (pagination)، تلاش دوباره (retry)، timeout، ذخیرهسازی، لاگ و حجم بالای درخواستها هم کنار بیاد.
قبل از اسکرپینگ، یه سؤال مهمتر بپرس
یکی از اشتباههای رایج اینه که خیلی زود میریم سراغ انتخاب کتابخونه:
BeautifulSoup استفاده کنم یا Scrapy؟
در حالی که هنوز نمیدونیم اصلاً اسکرپینگ بهترین راهحل هست یا نه.
قبل از انتخاب ابزار، اول این سؤالها رو جواب بده:
- دقیقاً چه دادهای لازم داری؟
- این داده هر چند وقت یه بار عوض میشه؟
- چند صفحه و چند سایت درگیرن؟
- داده از طریق API قابل گرفتنه یا نه؟
- صفحه با JavaScript ساخته میشه؟
- خروجی قراره کجا استفاده بشه؟
- اگه فردا ساختار سایت عوض شد، کی سیستم رو نگهداری میکنه؟
جواب این سؤالها خیلی بیشتر از انتخاب بین دو تا کتابخونه روی معماری پروژه اثر میذاره.
وب اسکرپینگ کی واقعاً ارزش داره؟
چند تا سناریو هست که اسکرپینگ کاملاً منطقیه.
دادهای که API مناسبی نداره
اطلاعاتی که لازم داری عمومی روی سایت نمایش داده میشه، ولی هیچ API قابلاستفادهای برای گرفتنش به شکل ساختاریافته نیست. اینجا اسکرپینگ یه راه عملیه؛ البته بعد از اینکه شرایط استفادهی سایت و قوانین مربوط به اون داده رو چک کردی.
پایش تغییرات
اسکرپینگ فقط «جمع کردن داده» نیست؛ میتونی تغییرات یه سایت رو هم زیر نظر بگیری:
Product Page
     ↓
Extract Price
     ↓
Compare With Previous Value
     ↓
Changed?
   ↙     ↘
 Yes      No
  ↓        ↓
Notify    Ignore
مثلاً قیمت یه محصول، وضعیت موجودی، تغییر یه صفحه یا اضافه شدن یه مورد جدید. اینجا ارزش اصلی از خود اسکرپینگ نمیاد؛ از کاری میاد که بعد از استخراج روی داده انجام میدی.
جمعآوری داده برای تحلیل
گاهی لازم نیست داده لحظهای باشه. ممکنه بخوای هر روز اطلاعات چند هزار صفحه رو جمع کنی و بعد تحلیلش کنی. اینجا اسکرپینگ میشه مرحلهی اول یه pipeline داده:
Web
 ↓
Crawler
 ↓
Raw Data
 ↓
Cleaning
 ↓
Database
 ↓
Analysis
 ↓
Dashboard / Report
اتوماسیون یه کار تکراری
گاهی چیزی که بهش میگیم اسکرپینگ، در واقع ترکیب اسکرپینگ و اتوماسیونه: وارد یه سایت شو، یه عبارت رو جستجو کن، نتیجهها رو باز کن، اطلاعات رو بردار، ذخیره کن و یه کار مشخص انجام بده. توی همچین پروژهای ممکنه HTML ساده کافی نباشه و به اتوماسیون مرورگر (browser automation) نیاز پیدا کنی.
کی API انتخاب بهتریه؟
اگه برای دادهای که میخوای یه API رسمی و مناسب وجود داره، معمولاً اولین گزینهایه که باید بررسیش کنی؛ چون API برای دسترسی ماشینی به داده طراحی شده.
بهجای اینکه HTML رو بگیری و از داخلش قیمت رو بیرون بکشی، یه endpoint مستقیم همچین چیزی برمیگردونه:
{
    "id": 123,
    "name": "Product A",
    "price": 1250000,
    "available": true
}
دیگه به ساختار HTML وابسته نیستی. یعنی معمولاً:
- parsing کمتر
- وابستگی کمتر به ظاهر صفحه
- خطای کمتر
- نگهداری سادهتر
- دادهی ساختاریافتهتر
البته API همیشه بهترین انتخاب نیست؛ ممکنه محدودیت تعداد درخواست، هزینه، احراز هویت یا محدودیت داده داشته باشه. پس هزینه و محدودیتهای واقعی هر دو روش رو کنار هم بذار.
قبل از هر کاری، تب Network رو نگاه کن
یه ترفند که توی پروژههای واقعی زیاد به کار میاد: خیلی از سایتهایی که با JavaScript ساخته شدن، دادهشون رو از یه آدرس JSON داخلی میگیرن. ابزار توسعهدهندهی مرورگر (F12) رو باز کن، برو تب Network، فیلتر Fetch/XHR رو بزن و صفحه رو دوباره لود کن.
اگه پاسخی پیدا کردی که دادهی تمیز و ساختاریافته برمیگردونه، معمولاً میتونی همون رو مستقیم با requests بگیری؛ بدون parse کردن HTML و بدون اجرای مرورگر. فقط یادت باشه این آدرسها رسمی و مستند نیستن و ممکنه بیخبر عوض بشن، پس شرایط استفادهی سایت اینجا هم صدق میکنه.
BeautifulSoup، Scrapy یا Playwright؟
این سه تا معمولاً کنار هم اسم برده میشن، ولی دقیقاً جایگزین هم نیستن.
BeautifulSoup
برای parse کردن HTML و بیرون کشیدن اطلاعات ازش عالیه؛ مخصوصاً وقتی HTML رو داری و فقط میخوای چند تا بخش مشخص رو استخراج کنی:
from bs4 import BeautifulSoup

html = """
<div class="product">
    <h2>Keyboard</h2>
    <span class="price">120</span>
</div>
"""

soup = BeautifulSoup(html, "html.parser")

title = soup.select_one(".product h2")
price = soup.select_one(".product .price")

print(title.get_text(strip=True))
print(price.get_text(strip=True))
برای پروژههای ساده، همین کاملاً کافیه.
Scrapy
وقتی پروژه از چند صفحه و چند درخواست ساده بزرگتر میشه، Scrapy گزینهی جدیتریه. برای crawling ساخته شده و صف درخواستها (scheduler)، همزمانی، middleware، pipeline و ادامه دادن کار نیمهتموم رو آماده داره.
وقتی قراره هزاران یا میلیونها URL رو ساختاریافته پردازش کنی، استفاده از یه فریمورک تخصصی معمولاً منطقیتر از اینه که همهی این تیکهها رو از صفر بنویسی.
Playwright
حالا فرض کن بخش اصلی اطلاعات یه صفحه بعد از اجرای JavaScript ساخته میشه. اینجا HTML اولیهای که requests میگیره ممکنه اصلاً اون داده رو نداشته باشه.
اینجاست که اتوماسیون مرورگر با ابزاری مثل Playwright به کار میاد. Playwright واقعاً یه مرورگر رو اجرا و کنترل میکنه، پس میتونی صبر کنی تا داده لود بشه و بعد برش داری:
import asyncio

from playwright.async_api import async_playwright


async def main():
    async with async_playwright() as p:
        browser = await p.chromium.launch()
        page = await browser.new_page()

        await page.goto("https://example.com/products")

        # Wait until JavaScript has rendered the product list.
        await page.wait_for_selector(".product")

        titles = await page.locator(".product .title").all_inner_texts()
        print(titles)

        await browser.close()


asyncio.run(main())
ولی این قدرت هزینه هم داره: اجرای مرورگر خیلی بیشتر از یه درخواست HTTP ساده CPU و RAM مصرف میکنه و کندتره. پس برای هر پروژهای مستقیم سراغ Playwright نرو.
یه قانون ساده برای انتخاب ابزار
میتونی از اینجا شروع کنی:
API رسمی و مناسب وجود دارد؟
  ├── بله → اول API را بررسی کن
  └── خیر
       ↓
داده در HTML اولیه هست؟
  ├── خیر → در تب Network، JSON داخلی هست؟
  │          ├── بله → همان را با requests بگیر
  │          └── خیر → Playwright (اتوماسیون مرورگر)
  └── بله
       ↓
حجم پروژه چقدر است؟
  ├── کم  → requests + BeautifulSoup
  └── زیاد → Scrapy
این قانون مطلق نیست، ولی جلوی یه اشتباه رایج رو میگیره: اینکه از قویترین ابزار شروع کنیم، فقط چون میتونیم.
هزینهی واقعی اسکرپینگ فقط نوشتن کد نیست
فرض کن یه اسکرپر رو یهروزه ساختی. پروژه تموم شده؟ احتمالاً نه.
چون سایت مقصد ممکنه فردا:
- کلاسهای HTML رو عوض کنه
- آدرس صفحهها رو تغییر بده
- صفحهبندی رو عوض کنه
- داده رو با JavaScript لود کنه
- یه جور دیگه جواب بده
- محدودیت تعداد درخواست (rate limit) بذاره
- دسترسی خودکار رو محدود کنه
یعنی اسکرپینگ یه هزینهی مهم داره که اول پروژه معمولاً دیده نمیشه: هزینهی نگهداری.
اگه اسکرپر برای یه کار موقت ساخته شده، شاید این هزینه قابلقبول باشه. ولی اگه قراره ماهها هر روز اجرا بشه، باید از اول مانیتورینگ و مدیریت خطا رو جدی بگیری.
اسکرپر خوب باید با خطا کنار بیاد
یه اسکرپر ساده ممکنه این شکلی باشه:
response = requests.get(url)

data = parse(response.text)

save(data)
ولی توی پروژهی واقعی حداقل به اینها فکر کن:
Request
  ↓
Timeout?
  ├── Yes → Retry / Log
  └── No
       ↓
Valid Response?
  ├── No → Log / Skip
  └── Yes
       ↓
Expected Structure?
  ├── No → Alert
  └── Yes
       ↓
Extract
       ↓
Validate
       ↓
Save
چون بدترین حالت همیشه این نیست که برنامه crash کنه. گاهی بدترین حالت اینه که برنامه بدون هیچ خطایی اجرا بشه، ولی دادهی غلط ذخیره کنه.
مثلاً selector عوض شده و برنامه بهجای قیمت واقعی یه مقدار دیگه برمیداره. سیستم ممکنه ساعتها یا روزها دادهی غلط تولید کنه، بدون اینکه متوجه بشی. واسه همین مرحلهی Validate مهمه: قیمت منفی یا خالی، عدد عجیب یا فیلدی که نباید خالی باشه، باید همون لحظه هشدار بده.
اتفاقی که روی اسکرپر خودم افتاد
چند سال پیش یه اسکرپر برای جمع کردن اطلاعات محصولات دیجیکالا نوشتم. جزئیات زیادی ازش یادم نمونده، ولی دو تا چیزش هنوز خوب یادمه.
اولی دادهی غلط بود. گاهی اسکرپر بدون هیچ خطایی اجرا میشد، ولی چیزی که جمع کرده بود اشتباه یا بههمریخته بود و باید ساعتها وقت میذاشتم تا مرتبش کنم. یعنی وقتی که قرار بود با اتوماسیون صرفهجویی بشه، صرف تمیزکاری دستی میشد.
دومی تغییر مسیرها بود. هر بار که آدرس صفحهها یا ساختارشون عوض میشد، اسکرپر به خطا میخورد و باید دوباره درستش میکردم.
اون موقع اسمش رو نمیدونستم، ولی این دقیقاً همون هزینهی نگهداری بود که بالاتر گفتم. اگه امروز بخوام دوباره همون اسکرپر رو بسازم، اول از همه مرحلهی اعتبارسنجی داده رو میذارم و یه هشدار که اگه ساختار صفحه عوض شد، همون لحظه خبردار بشم؛ نه بعد از اینکه کلی دادهی خراب جمع شده.
سرعت بیشتر همیشه بهتر نیست
وقتی تعداد صفحهها زیاده، وسوسه میشی درخواستها رو تا جای ممکن همزمان بفرستی. ولی اسکرپینگ مسابقهی سرعت نیست.
اگه با همزمانی خیلی بالا به یه سایت درخواست بفرستی، ممکنه:
- خودت منابع بیشتری مصرف کنی
- درخواستهای بیشتری خطا بخورن
- سرور مقصد زیر فشار بره
- rate limit فعال بشه یا مسدود بشی
- کیفیت داده پایین بیاد
برای crawlerهای جدی، کنترل همزمانی و سرعت درخواست خیلی مهمه. Scrapy حتی یه قابلیت به اسم AutoThrottle داره که سرعت crawl رو خودکار بر اساس زمان پاسخ سرور تنظیم میکنه.
هدف این نیست که «هر چی سریعتر سایت رو بزنیم»؛ هدف اینه که با یه سرعت پایدار و منطقی، دادهی لازم رو جمع کنیم.
robots.txt و قوانین رو نادیده نگیر
فایل robots.txt یه استاندارد شناختهشده (RFC 9309) برای اعلام قوانین دسترسی crawlerهاست. ولی یه نکتهی مهم داره: robots.txt سیستم احراز هویت یا کنترل دسترسی نیست.
یعنی اگه یه مسیر توی robots.txt بسته شده، از نظر فنی دسترسی بهش غیرممکن نمیشه؛ فقط صاحب سایت گفته نمیخواد crawlerها اونجا برن، و یه اسکرپر مسئول باید به این احترام بذاره.
از طرف دیگه، اینکه robots.txt چیزی رو منع نکرده، به این معنی نیست که هر استفادهای از داده مجازه. شرایط استفادهی سایت و قوانین محل فعالیتت هم مهمن؛ مخصوصاً اگه دادهای که جمع میکنی اطلاعات شخصی آدمهاست (اسم، شماره، ایمیل)، چون جمعآوری و نگهداری این نوع داده توی خیلی از کشورها قوانین سختگیرانهی خودش رو داره.
کی اصلاً اسکرپر نسازیم؟
به نظرم این بخش از کل مقاله مهمتره. گاهی بهترین تصمیم اینه که اصلاً اسکرپر نسازی؛ مثلاً اگه:
- API رسمی و مناسب وجود داره
- حجم داده خیلی کمه و دستی انجام دادنش منطقیه
- سایت مدام ساختارش رو عوض میکنه
- هزینهی نگهداری از ارزش داده بیشتره
- دادهای که میخوای ارزش تجاری خاصی نداره
- منبع دادهی جایگزین سادهتری وجود داره
توی این شرایط، ساختن اسکرپر فقط پیچیدگی اضافه درست میکنه.
در عوض، اگه اسکرپینگ کلی وقت صرفهجویی میکنه، دادهای رو جمع میکنه که جایگزین مناسبی نداره یا یه فرایند خودکار و پایدار میسازه، ارزشش خیلی بیشتره.
قبل از شروع پروژه، این ۷ سؤال رو جواب بده
اگه بخوام یه پروژهی اسکرپینگ رو قبل از نوشتن حتی یه خط کد بررسی کنم، اینها رو میپرسم:
- دقیقاً چه دادهای لازم داریم؟
- منبع داده چیه و چند صفحه باید بررسی بشه؟
- API یا feed قابلاستفادهای وجود داره؟
- داده هر چند وقت یه بار عوض میشه؟
- JavaScript یا اتوماسیون مرورگر لازمه؟
- این سیستم قراره یه بار اجرا بشه یا ماهها و سالها؟
- اگه سایت عوض شد، هزینهی نگهداری چقدر میشه؟
اگه جواب این سؤالها روشن نیست، احتمالاً هنوز برای کدنویسی زوده.
جمعبندی
وب اسکرپینگ فقط «گرفتن اطلاعات از سایت» نیست. وقتی پروژه واقعی میشه، باید به معماری، حجم درخواستها، کیفیت داده، خطاها، تغییر ساختار سایت، نگهداری و هزینهی زیرساخت هم فکر کنی.
برای یه صفحهی ساده، شاید چند خط پایتون تمام چیزی باشه که لازم داری. برای هزاران صفحه و یه سیستم دائمی، احتمالاً به crawler، صف، دیتابیس، مانیتورینگ و مدیریت خطا نیاز پیدا میکنی. و گاهی هم بهترین تصمیم اینه که اصلاً اسکرپ نکنی و بری سراغ API یا یه منبع دادهی بهتر.
من معمولاً اینجوری بهش نگاه میکنم:
ابزار مهمه، ولی درست فهمیدن مسئله از انتخاب ابزار مهمتره.
اگه هدفت فقط استخراج داده نیست و میخوای این کار رو به یه سیستم خودکار و قابلنگهداری تبدیل کنی، خدمات وب اسکرپینگ و اتوماسیونم رو ببین.
سؤالات متداول
وب اسکرپینگ چیست؟
وب اسکرپینگ یعنی استخراج خودکار اطلاعات از صفحههای وب و تبدیلش به دادهای که بشه توی فایل، دیتابیس یا یه سیستم دیگه ازش استفاده کرد.
برای وب اسکرپینگ پایتون بهتره یا زبانهای دیگه؟
پایتون بهخاطر اکوسیستم قویاش توی اسکرپینگ، پردازش داده و اتوماسیون، انتخاب خیلی خوبیه. ولی انتخاب زبان به پروژه و زیرساخت موجود هم بستگی داره و زبان بهتنهایی تعیینکننده نیست.
برای اسکرپینگ از BeautifulSoup استفاده کنیم یا Playwright؟
هیچکدوم همیشه بهتر نیست. اگه داده توی HTML اولیه هست، BeautifulSoup کافیه. اگه صفحه برای نمایش داده به JavaScript یا تعامل با مرورگر نیاز داره، Playwright مناسبتره. برای crawling در مقیاس بالا هم Scrapy معماری بهتری داره.