
اگه یه ربات تلگرام رو با چند تا کاربر تست کرده باشی، احتمالاً همهچی کاملاً عادی به نظر رسیده؛ پیامها سریع جواب میگیرن، دکمهها بدون تأخیر کار میکنن و دیتابیس هم مشکلی نداره. ولی تا کاربرها زیاد میشن، یهو اوضاع عوض میشه: بعضی پیامها دیر جواب میگیرن، callbackها با تأخیر اجرا میشن و گاهی چند تا درخواست ساده باعث میشه کل ربات چند ثانیه کند بشه.
اولین واکنش معمولاً اینه که بریم سراغ یه سرور قویتر. ولی توی خیلی از پروژههایی که دیدم، مشکل اصلی CPU یا RAM نبوده. گلوگاه واقعی توی خود برنامه بوده؛ یه درخواست شبکه که منتظر مونده، یه query نامناسب، یه کار سنگین داخل handler یا کدی که event loop رو قفل کرده.
توی این مقاله علتهای رایج کند شدن ربات تلگرام با زیاد شدن کاربرها رو با هم مرور میکنیم و میگم برای پیدا کردن و حل مشکل از کجا باید شروع کنی.
کند شدن ربات تلگرام دقیقاً یعنی چی؟
قبل از بهینهسازی باید بدونیم دقیقاً از چی حرف میزنیم.
فرض کن کاربر روی یه دکمه میزنه و ربات باید اطلاعات حسابش رو از دیتابیس بخونه، یه درخواست به یه سرویس دیگه بفرسته و آخرش نتیجه رو توی تلگرام نشون بده.
اگه این کار برای یه کاربر ۲۰۰ میلیثانیه طول بکشه، در نگاه اول مشکلی نیست. ولی اگه صدها کاربر همزمان همین handler رو اجرا کنن، همین ۲۰۰ میلیثانیه میتونه تبدیل بشه به یه صف از درخواستهای منتظر.
پس کندی فقط به این معنی نیست که «یه تابع زیادی طول میکشه».
گاهی هر درخواست بهتنهایی سریعه، ولی تعداد زیاد درخواستهای همزمان باعث میشه منابع مشترک مثل connectionهای دیتابیس، CPU، شبکه یا event loop زیر فشار برن.
واسه همین بهتره عملکرد ربات رو چند تیکه کنیم:
- زمان دریافت update
- زمان اجرای handler
- زمان دسترسی به دیتابیس
- زمان انتظار برای سرویسهای بیرونی
- زمان فرستادن جواب به تلگرام
- تعداد درخواستهایی که همزمان در حال پردازشن
وقتی این تفکیک رو داشته باشی، پیدا کردن گلوگاه خیلی راحتتر میشه.
مهمترین دلیل کندی: کدهای blocking
اگه از aiogram یا هر کتابخونهی asynchronous دیگهای استفاده میکنی، یکی از مهمترین قانونها اینه که هیچوقت event loop رو با کار blocking قفل نکنی.
مثلاً این کد رو ببین:
import time

async def handler(message):
    time.sleep(5)

    await message.answer("Done")
ظاهر کد asynchronousه، ولی time.sleep() asynchronous نیست.
توی این پنج ثانیه، event loop کامل متوقف میمونه. یعنی مشکل فقط مال همون کاربر نیست؛ همهی taskهای دیگهای هم که باید توسط همین event loop پردازش بشن، منتظر میمونن.
یه راه ساده برای کارهای blocking از نوع I/O، استفاده از asyncio.to_thread()ه:
import asyncio
import time

def blocking_operation():
    time.sleep(5)
    return "Done"

async def handler(message):
    result = await asyncio.to_thread(blocking_operation)

    await message.answer(result)
البته to_thread() نسخهی همهکاره برای هر کار سنگینی نیست. برای کارهای واقعاً CPU-bound باید سراغ معماری مناسبتری مثل process pool یا یه worker جدا بری.
چه چیزایی معمولاً blocking هستن؟
چند تا مورد رایج:
time.sleep()- خوندن و نوشتن فایل به روش synchronous توی مسیر پرترافیک
- کتابخونههای HTTP synchronous مثل
requests - کار سنگین روی فایلهای بزرگ
- پردازش تصویر یا ویدئو
- اجرای subprocessهای طولانی
- scraping یا پردازش HTML داخل handler
- محاسبات CPU-intensive
یه اشتباه رایج اینه که چون تابع اصلی با async def نوشته شده، فکر کنیم هر چی داخلشه هم asynchronousه. این فکر غلطه.
async def فقط نصف ماجراست؛ کدی که داخلش اجرا میشه هم باید با مدل asynchronous جور باشه.
دیتابیس؛ جایی که خیلی از رباتها واقعاً کند میشن
توی پروژههای کوچیک، queryهای دیتابیس معمولاً زیاد به چشم نمیان.
مثلاً اگه برای هر درخواست یه query ساده اجرا کنیم:
user = await get_user(user_id)
احتمالاً همهچی خوبه.
ولی وقتی handler شروع میکنه چند تا query پشت سر هم بزنه، اوضاع فرق میکنه:
get user
    ↓
get profile
    ↓
get courses
    ↓
get wallet
    ↓
get referrals
    ↓
get notifications
اگه هر مرحله یه رفتوبرگشت (round trip) جدا لازم داشته باشه، زمان جواب کمکم بالا میره.
از این بدتر وقتیه که داخل یه حلقه query بزنیم:
for course in courses:
    result = await get_course_statistics(course.id)
اگه ۵۰ تا دوره داشته باشیم، یه درخواست کاربر تبدیل میشه به دهها query.
به این الگو معمولاً N+1 Query Problem میگن.
راهحل همیشه این نیست که همهی queryها رو همزمان اجرا کنیم. اول باید ببینیم واقعاً چه دادهای لازم داریم و آیا میشه با یه query بهتر، join، aggregation، caching یا یه ساختار مناسبتر، همون اطلاعات رو با درخواستهای کمتر گرفت.
یه اصل مهم
قبل از اینکه دیتابیس رو بهینه کنی، queryهای واقعی رو اندازه بگیر.
بهینهسازی حدسی معمولاً جواب خوبی نمیده.
گاهی queryای که فکر میکنیم سنگینه، کاملاً اوکیه و مشکل اصلی یه جای دیگهست.
درخواستهای بیرونی رو توی مسیر اصلی ول نکن
فرض کن کاربر روی یه دکمه میزنه و ربات باید از یه API بیرونی اطلاعات بگیره:
async def handler(message):
    data = await external_api_request()

    await message.answer(data)
اگه سرویس بیرونی سریع باشه، مشکلی نیست.
ولی اگه اون API پنج ثانیه طول بکشه، handler تو هم پنج ثانیه منتظر میمونه.
حالا اگه صدها کاربر تقریباً همزمان همین درخواست رو بفرستن، کلی task منتظر یه سرویس بیرونی میمونن.
این موضوع مخصوصاً توی رباتهایی که از این سرویسها استفاده میکنن مهمه:
- APIهای هوش مصنوعی
- درگاههای پرداخت
- سرویس پیامک
- APIهای دانشگاه یا سازمان
- سرویسهای جستجو
- سرویسهای scraping
- سایتهای شخص ثالث
توی این شرایط باید ببینی واقعاً لازمه کاربر تا آخر کار منتظر بمونه، یا میشه کار رو سپرد به یه background worker.
مثلاً:
User
  ↓
Telegram Bot
  ↓
Create Job
  ↓
Queue
  ↓
Worker
  ↓
External API
  ↓
Save Result
  ↓
Notify User
توی این معماری، handler مجبور نیست چند ثانیه یا چند دقیقه منتظر بمونه.
هر کاری رو نباید داخل handler انجام داد
یکی از اشتباههایی که توی پروژههای ربات زیاد میبینم اینه که handler میشه جای انجام همهی کارهای سیستم.
مثلاً:
async def download_handler(message):
    file = await download_file()
    data = process_file(file)
    result = scrape_website(data)
    result = generate_report(result)
    await save_to_database(result)
    await message.answer("Done")
در نگاه اول شاید کد کاملاً منطقی به نظر بیاد.
ولی handler اینجا کلی مسئولیت گردنش افتاده.
اگه scrape_website() طول بکشه یا generate_report() سنگین باشه، جواب ربات هم دیر میرسه؛ و چون process_file() و scrape_website() تابعهای معمولی (sync) هستن، تمام مدتی که اجرا میشن event loop هم قفله.
بهتره handler بیشتر نقش هماهنگکننده رو داشته باشه:
import asyncio
background_tasks = set()
async def download_handler(message):
job_id = await create_job(message.from_user.id)
await message.answer(
"درخواستت ثبت شد. نتیجه که آماده شد، برات میفرستم."
)
task = asyncio.create_task(process_job(job_id))
background_tasks.add(task)
task.add_done_callback(background_tasks.discard)
اینکه یه ارجاع به task رو توی background_tasks نگه داشتیم عمدیه: طبق مستندات پایتون، taskی که هیچ ارجاعی بهش نمونده ممکنه وسط کار توسط garbage collector پاک بشه.
البته asyncio.create_task() هم برای هر جور job مناسب نیست. اگه کار مهمه، طولانیه یا باید در صورت خطا دوباره اجرا بشه، queue و worker مستقل معمولاً انتخاب مطمئنتریه؛ چون با ریاستارت شدن ربات، taskهای داخل حافظه از بین میرن.
همزمانی بیشتر همیشه یعنی سرعت بیشتر؟
یه تصور اشتباه دیگه اینه:
هر چی task بیشتری همزمان اجرا کنیم، ربات سریعتر میشه.
نه لزوماً.
فرض کن رباتت میتونه ۵۰۰ تا task همزمان بسازه، ولی دیتابیس فقط تعداد محدودی connection مؤثر داره.
اگه بدون محدودیت task بسازی، ممکنه بهجای سرعت بیشتر، فقط فشار بیشتری به سیستم بیاری.
توی aiogram 3، هر update بهطور پیشفرض توی یه task جدا پردازش میشه و توی polling میتونی تعداد پردازشهای همزمان رو محدود کنی.
مثلاً:
await dp.start_polling(
    bot,
    tasks_concurrency_limit=100,
)
عدد ۱۰۰ عدد جادویی نیست.
باید بر اساس ظرفیت واقعی برنامه، دیتابیس، APIهای بیرونی و منابع سرور انتخاب بشه.
گاهی محدود کردن همزمانی باعث میشه سیستم زیر فشار پایدارتر بمونه، حتی اگه حداکثر throughput یه کم پایین بیاد.
هدف فقط «بیشترین سرعت» نیست؛ هدف اینه که سیستم زیر بار واقعی هم رفتار قابل پیشبینی داشته باشه.
Polling یا Webhook؛ کدوم سریعتره؟
تلگرام برای گرفتن update دو تا روش اصلی داره:
- Long Polling با
getUpdates - Webhook با
setWebhook
این دو تا جایگزین همدیگهان و نمیشه همزمان از هر دو برای گرفتن update استفاده کرد.
Webhook میتونه برای محیط production انتخاب خوبی باشه، مخصوصاً وقتی زیرساختت از قبل بر پایهی HTTP و reverse proxyه.
ولی انتظار نداشته باش فقط با عوض کردن polling به webhook، همهی مشکلات performance حل بشه.
اگه مسیرت این شکلیه:
Telegram
   ↓
Webhook
   ↓
Slow Handler
   ↓
Slow Database
عوض کردن polling به webhook مشکل دیتابیس رو حل نمیکنه.
Webhook فقط مسیر رسیدن update رو عوض میکنه؛ معماری داخلی برنامه هنوز حرف اول رو میزنه.
Cache میتونه کلی درخواست رو حذف کنه
لازم نیست همهی دادهها هر بار از دیتابیس یا API بیرونی خونده بشن.
مثلاً فرض کن منوی اصلی ربات برای همهی کاربرها تقریباً یکیه، یا اطلاعات یه درس، دانشگاه یا تنظیمات عمومی تا چند دقیقه عوض نمیشه.
توی این شرایط cache میتونه خیلی به کارت بیاد.
یه مدل ساده:
cache = {}

async def get_university_name(university_id):
    if university_id in cache:
        return cache[university_id]

    university = await load_from_database(university_id)

    cache[university_id] = university.name

    return university.name
البته این مثال برای production کافی نیست: با ریاستارت برنامه cache پاک میشه، بین چند process مشترک نیست، زمان انقضا نداره و بیحد بزرگ میشه.
برای یه سیستم جدیتر میتونی از Redis یا ابزارهای caching مناسب استفاده کنی.
ولی مهمتر از خود ابزار اینه که اول مشخص کنی چه چیزی ارزش cache شدن داره.
cache کردن همهچی معمولاً طراحی خوبی نیست.
لاگ و اندازهگیری رو جدی بگیر
اگه ندونی کدوم بخش کنده، بهینهسازی بیشتر شبیه حدس زدنه.
حداقل باید بتونی زمان بخشهای مهم رو اندازه بگیری:
import time

start = time.perf_counter()

user = await get_user(user_id)

db_time = time.perf_counter() - start

print(f"Database: {db_time:.3f}s")
بعد میتونی بخشهای مختلف رو جدا جدا اندازه بگیری:
Handler total: 1.84s
Database:      0.21s
External API:  1.42s
Telegram:      0.17s
توی این مثال، بهینه کردن query دیتابیس احتمالاً تأثیر زیادی نداره.
گلوگاه اصلی API بیرونیه.
همین اندازهگیری ساده خیلی بهتر از اینه که بدون اطلاعات سرور رو ارتقا بدی یا کل پروژه رو از نو بنویسی.
از روی علائم، گلوگاه رو پیدا کن
چند تا الگوی رایج:
| علامت | احتمال بیشتر |
|---|---|
| همهی handlerها با هم کند میشن | event loop، CPU، دیتابیس یا منابع مشترک |
| فقط یه قابلیت خاص کنده | همون handler یا سرویسی که بهش وابستهست |
| با زیاد شدن کاربرها دیتابیس کند میشه | query، index، connection pool |
| فقط عملیات scraping کنده | درخواست بیرونی یا پردازش |
| callbackها هم دیر جواب میدن | کد blocking توی event loop |
| بعد از ریاستارت سریعه و دوباره کند میشه | احتمال نشت حافظه، رشد بیرویهی cache یا نشت منابع |
| CPU بالا میره | پردازش CPU-bound یا حلقهی سنگین |
| CPU پایینه ولی جوابها دیر میان | I/O، دیتابیس، شبکه یا انتظار برای یه سرویس دیگه |
این جدول تشخیص قطعی نیست؛ فقط یه نقطهی شروع خوب برای بررسیه.
کی باید سرور رو قویتر کنیم؟
بیشتر کردن منابع سرور چیز بدی نیست و گاهی دقیقاً راهحل درسته؛ ولی نباید اولین واکنشت باشه.
اگه CPU واقعاً ۱۰۰ درصده و کارت CPU-boundه، CPU بیشتر منطقیه.
اگه RAM کمه و سیستم میره روی swap، RAM بیشتر میتونه مشکل رو حل کنه.
ولی اگه وضعیت این باشه:
CPU = 15%
RAM = 40%
Database = slow
اضافه کردن CPU احتمالاً مشکل رو حل نمیکنه.
همین منطق برای شبکه، دیسک و connectionهای دیتابیس هم صدق میکنه.
من معمولاً قبل از دست بردن توی منابع، این سؤال رو از خودم میپرسم:
دقیقاً کدوم منبع گلوگاه شده؟
اگه جواب روشنی براش نداری، هنوز برای خریدن سرور قویتر زوده.
اتفاقی که روی ربات خودم افتاد
چند وقت پیش یکی از رباتهایی که با aiogram ساختم (یه ربات دانشجویی برای فروش جزوه و فایل) رو بردم روی یه سرور جدید. ربات قبلی روی یه هاست دیگه کمتر از یه ثانیه جواب میداد؛ نسخهی جدید گاهی ۳۰ ثانیه طول میکشید و گاهی اصلاً جواب نمیداد، حتی با دو تا کاربر.
بهجای حدس زدن، چند تا ابزار اندازهگیری ساده به ربات اضافه کردم:
- لاگ
SLOW handlerبرای handlerهای بالای ۲ ثانیه - لاگ
SLOW DBبرای queryهای بالای نیم ثانیه - یه مانیتور کوچیک که هر ۰٫۲۵ ثانیه میخوابه و تأخیر بیدار شدنش رو اندازه میگیره؛ یعنی اندازهگیری مستقیم قفل شدن event loop
نتیجه جالب بود: دو دسته مشکل همزمان وجود داشت.
مشکلای کد، که همهشون توی همین مقاله اومدن:
- جستجوی گروه برای هر جزوه یه query جدا میزد؛ بیشتر از ۱۲۰ تا query برای هر جستجو. یه N+1 کلاسیک که با یه query تبدیل شد به یکی.
bot.get_me()توی هر درخواست صدا زده میشد؛ یعنی یه رفتوبرگشت اضافه به تلگرام. نسخهی کششدهش جاش نشست.- اطلاعات کاتالوگ توی هر درخواست از MySQL خونده میشد. یه cache پنجدقیقهای که با هر تغییر پاک میشه، اینها رو حذف کرد.
- لاگنویسی و ثبت تاریخچه sync بودن و منتقل شدن به thread و صف جدا.
- و یه باگ غافلگیرکننده: علت «اصلاً جواب ندادن» اصلاً کندی نبود! پیامها با Markdown فرستاده میشدن و اگه اسم یه فایل
_یا*داشت، تلگرام خطایcan't parse entitiesمیداد و کاربر هیچ جوابی نمیگرفت. از دید کاربر، این هم یعنی «ربات کنده».
مشکل سرور: بعد از رفع همهی اینها، باز هم EVENT LOOP BLOCKED با ۱۵ و ۱۸ ثانیه توی لاگ میومد، حتی وقتی هیچ کاربری پیام نمیداد. یه اسکریپت پایتون که فقط sleep میکرد، بدون دیتابیس و بدون دیسک، تا ۱۲٫۵ ثانیه متوقف میشد. vmstat نشون داد CPU steal تا ۴۲٪ و iowait تا ۵۷٪ بالا میره، و نوشتن ۴ کیلوبایت روی دیسک گاهی ۲۹ ثانیه طول میکشید؛ اون هم با باری نزدیک صفر. یعنی خود ماشین مجازی روی host فریز میشد.
درسی که از این تجربه گرفتم این بود که «مشکل از کده» و «مشکل از سروره» میتونن همزمان درست باشن. اگه اندازه نمیگرفتم، یا سرور رو بیدلیل ارتقا میدادم و باگهای کد سر جاشون میموندن، یا روزها کدی رو بهینه میکردم که روی اون سرور هیچوقت سریع نمیشد. اندازهگیری بود که این دو تا رو از هم جدا کرد.
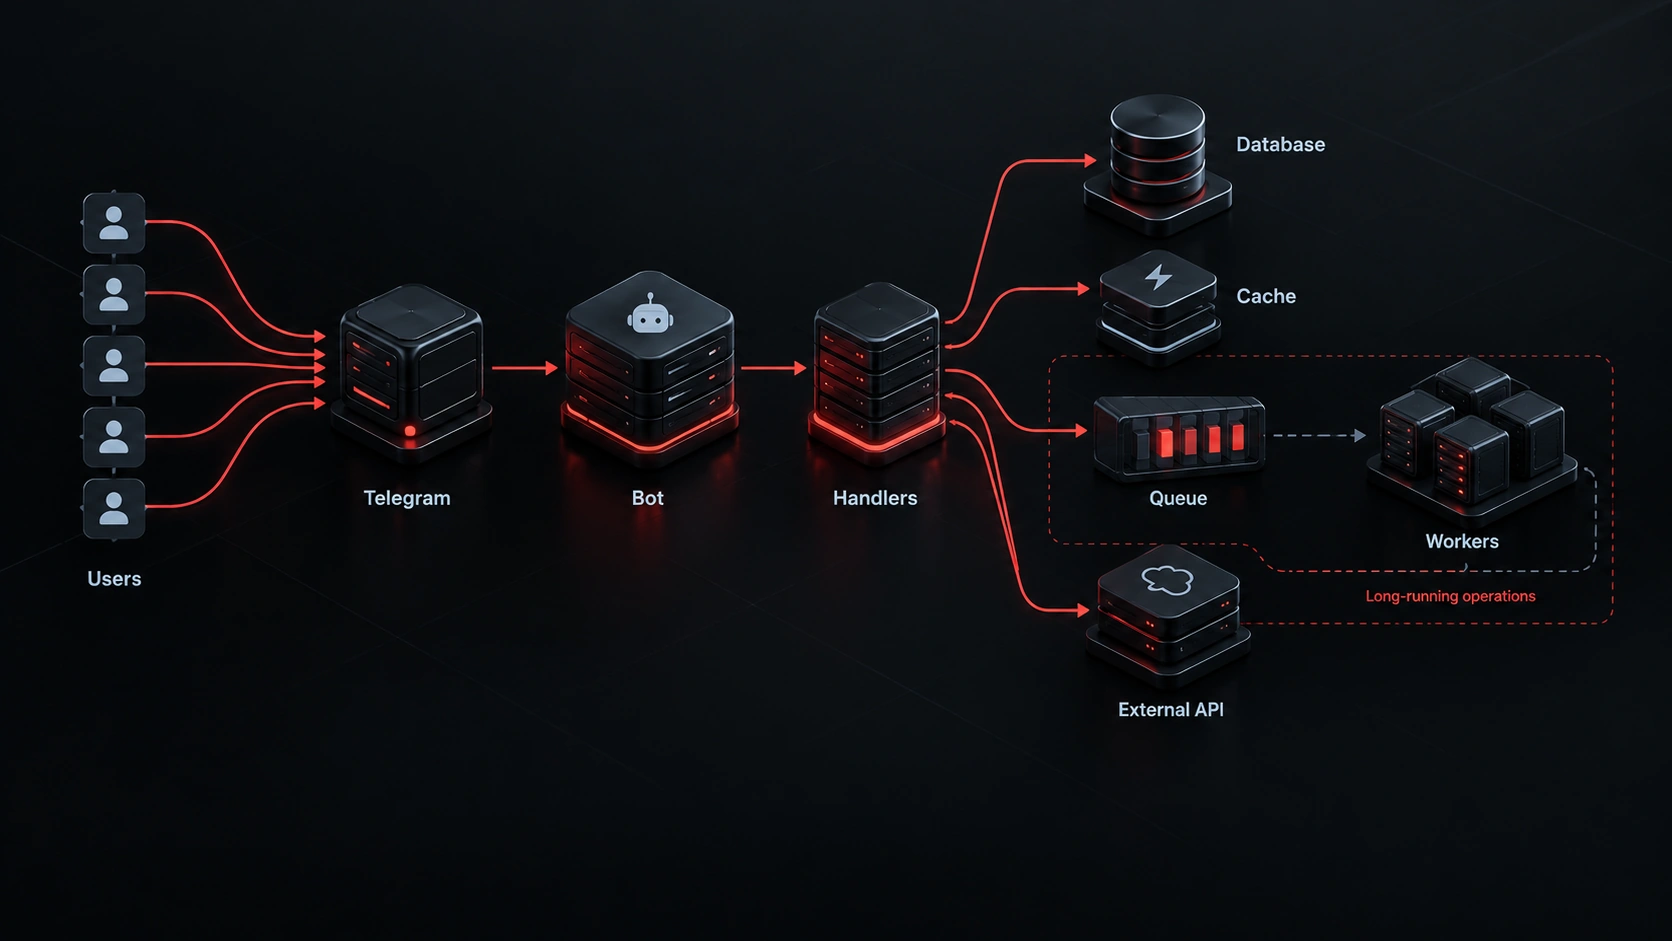
یه معماری بهتر برای رباتهایی که دارن بزرگ میشن
وقتی ربات از چند تا handler ساده فراتر میره، بهتره معماریش هم باهاش رشد کنه.
یه ساختار قابل توسعه میتونه یه چیزی شبیه این باشه:
                 Telegram
                     │
                     ▼
              ┌─────────────┐
              │   Bot App   │
              │   aiogram   │
              └──────┬──────┘
                     │
        ┌────────────┼────────────┐
        ▼            ▼            ▼
     Handler      Database      Cache
        │
        ▼
      Queue
        │
        ▼
     Workers
        │
   ┌────┴─────┐
   ▼          ▼
Scraping   External API
لازم نیست از روز اول همچین معماریای داشته باشی.
برای یه ربات کوچیک، این ساختار حتی ممکنه زیادی باشه.
ولی وقتی تعداد کاربرها، کارهای سنگین و سرویسهای بیرونی زیاد میشه، جدا کردن این مسئولیتها ارزشش رو نشون میده.
چکلیست پیدا کردن علت کندی
اگه رباتت این اواخر کند شده، پیشنهادم اینه که به این ترتیب پیش بری:
- زمان جواب handlerهای مختلف رو اندازه بگیر.
- دنبال
time.sleep()و بقیهی کارهای blocking بگرد. - درخواستهای HTTP و سرویسهای بیرونی رو اندازه بگیر.
- queryهای پرتکرار دیتابیس رو بررسی کن.
- دنبال الگوی N+1 Query بگرد.
- indexهای لازم دیتابیس رو چک کن.
- تعداد connectionهای دیتابیس رو چک کن.
- کارهای CPU-heavy رو از handler جدا کن.
- برای jobهای طولانی queue و worker در نظر بگیر.
- فقط بعد از پیدا کردن گلوگاه، منابع سرور رو بیشتر کن.
این ترتیب مهمه.
گاهی حذف یه query اضافه یا یه کار blocking نتیجهای میده که با چند برابر کردن منابع سرور هم به دست نمیاد.
جمعبندی
کند شدن ربات تلگرام با زیاد شدن کاربرها معمولاً فقط یه علت نداره.
ممکنه event loop با یه کار blocking قفل بشه، دیتابیس زیر بار queryهای زیاد بمونه، یه API بیرونی دیر جواب بده یا تعداد taskهای همزمان از ظرفیت واقعی سیستم بیشتر بشه.
واسه همین، بهینهسازی رو از «سرور قویتر» شروع نکن.
اول اندازه بگیر، بعد گلوگاه رو پیدا کن و بعد همون بخش رو درست کن.
ربات خوب فقط رباتی نیست که توی شرایط عادی سریع جواب بده؛ ربات خوب وقتی کاربرها و درخواستها بیشتر میشن هم رفتارش قابل پیشبینی میمونه.
اگه ربات تلگرامت بخشی از یه محصول بزرگتره و میخوای از همون اول معماریش درست چیده بشه، خدمات توسعهی ربات تلگرامم رو ببین.
سؤالات متداول
بیشتر کردن RAM ربات تلگرام رو سریعتر میکنه؟
فقط اگه RAM واقعاً گلوگاه باشه. اگه مشکل از query دیتابیس، event loop، درخواست بیرونی یا کار blocking باشه، RAM بیشتر تأثیر محسوسی نداره.
برای ربات تلگرام حتماً باید از Webhook استفاده کنیم؟
نه. تلگرام هم Long Polling رو پشتیبانی میکنه هم Webhook رو. انتخاب بینشون به معماری، زیرساخت و نیاز پروژه بستگی داره، و Webhook بهتنهایی مشکلات داخلی performance رو حل نمیکنه.
برای یه ربات تلگرام بزرگتر، aiogram کافیه؟
توی خیلی از پروژهها آره. معمولاً محدودیت اصلی خود کتابخونه نیست؛ معماری برنامه، دیتابیس، کارهای blocking، سرویسهای بیرونی و نحوهی مدیریت کارهای همزمانه که تعیینکنندهست.