امروز کافیه چند خط توضیح بنویسی تا یه ابزار هوش مصنوعی برات API بسازه، فرم ثبتنام طراحی کنه یا یه قابلیت تازه به پروژه اضافه کنه. کاری که قبلاً یه بعدازظهر وقت میگرفت، حالا در چند دقیقه به یه خروجی اولیه میرسه.
ولی سؤال اصلی بعد از همین چند دقیقه شروع میشه: این خروجی واقعاً آمادهی انتشاره؟ با معماری پروژه جور درمیاد؟ خطای پنهان نداره؟ شش ماه بعد کسی میتونه تغییرش بده؟
برنامهنویسی با هوش مصنوعی نوشتن کد رو سریعتر کرده، ولی سرعت تولید کد و سرعت تحویل نرمافزار قابل اتکا دو معیار متفاوتاند. این مقاله دربارهی فاصلهی بین همین دوتاست: چرا وجود داره، پژوهشها دربارهش چی میگن، و چطور میشه با ابزارهای هوش مصنوعی نرمافزاری ساخت که واقعاً کار کنه.
تولید کد با مهندسی نرمافزار فرق داره
این دو مفهوم معمولاً با هم قاطی میشن:
- تولید کد (code generation): نوشتن یه قطعه کد یا پیادهسازی یه قابلیت مشخص.
- مهندسی نرمافزار: فهمیدن مسئله، طراحی راهحل، انتخاب معماری، مدیریت وابستگیها، تست، استقرار و نگهداری؛ یعنی همهی کارهایی که یه قطعه کد رو به بخشی از یه سیستم قابل اتکا تبدیل میکنه.
فرض کن از یه ابزار هوش مصنوعی بخوای سیستم ثبتنام بسازه. احتمالاً در چند ثانیه فرم، مدل داده و endpoint تحویلت میده، و احتمالاً در سناریوی عادی هم درست کار میکنه. ولی اینها رو چی؟
- اگه کاربر دو بار پشتسرهم روی دکمه بزنه، دو حساب ساخته میشه؟
- اگه وسط ثبتنام اتصال به دیتابیس قطع بشه، دادهی نصفه میمونه؟
- کاربر میتونه با عوض کردن یه عدد توی آدرس، اطلاعات کاربر دیگه رو ببینه؟
- محدودیتهای کسبوکار، مثلاً «هر شماره فقط یه حساب»، کجا اعمال شده؟
هیچکدوم از این سؤالها توی درخواست اولیه نبودن، پس هیچ ابزاری هم مجبور نبوده جوابشون رو بده. درست اجرا شدن یه قطعه کد، لزوماً به معنی درست کار کردن کل سیستم نیست.
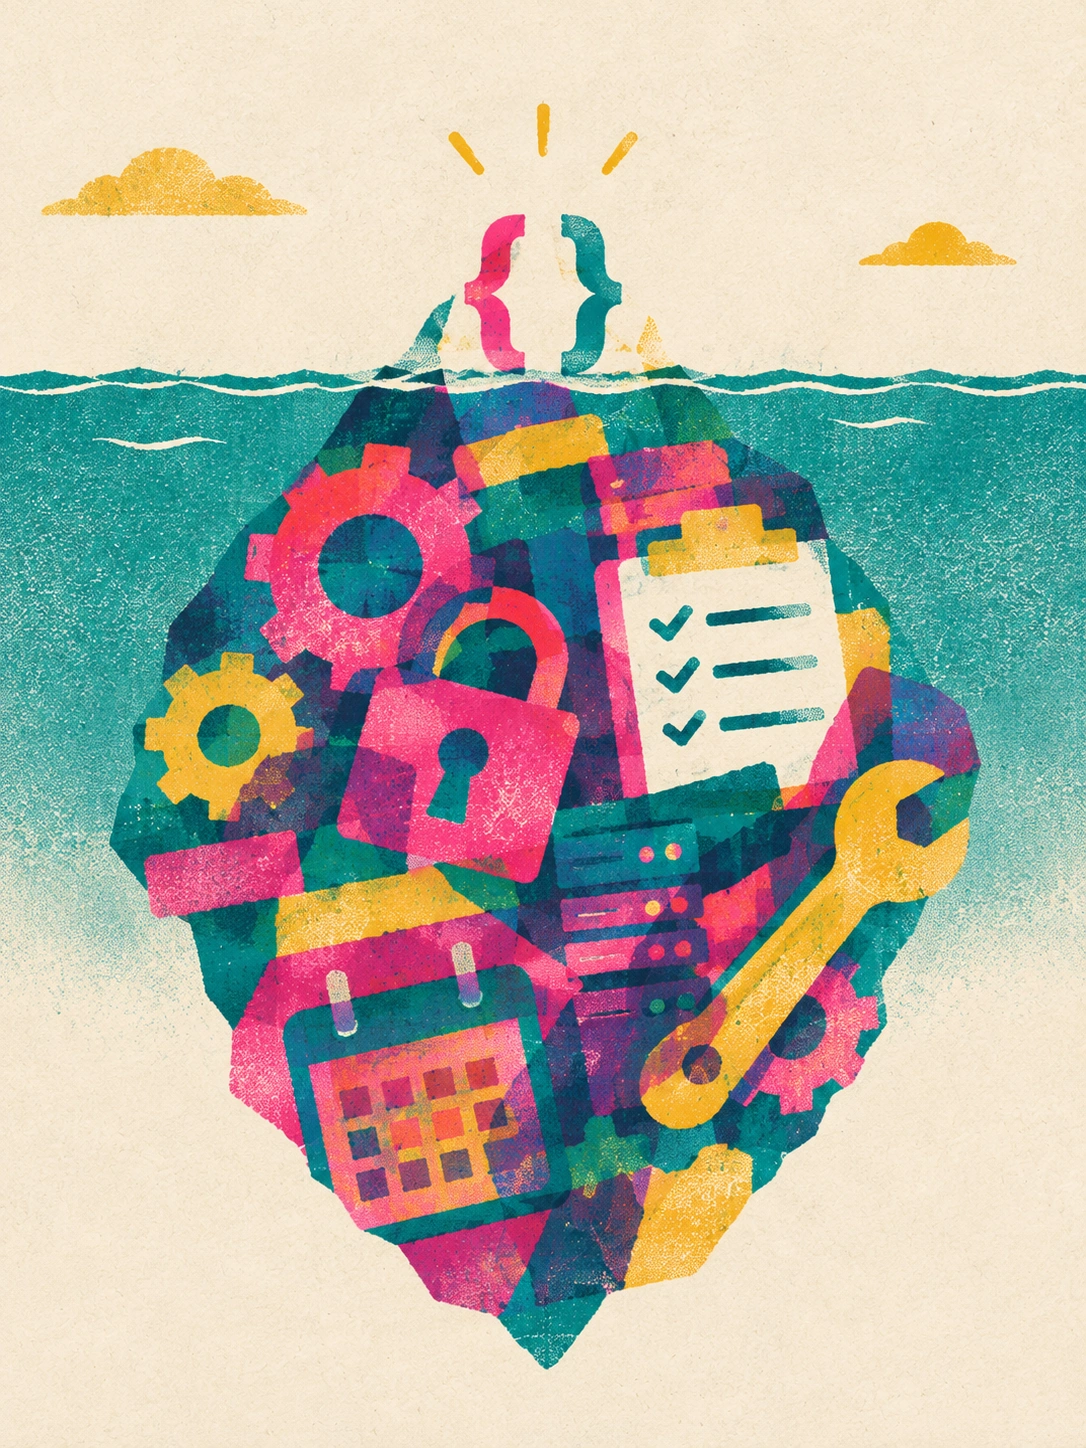
پنج چالشی که با تولید خودکار کد از بین نمیرن
۱. معماری و تصمیمهای فنی
ساختن یه قابلیت معمولاً سختترین بخش کار نیست؛ سخت اینه که اون قابلیت چطور به بقیهی سیستم وصل بشه. ابزاری که فقط فایل جلوی چشمش رو میبینه، ممکنه منطق اعتبارسنجی رو یه بار دیگه توی یه فایل تازه بنویسه، در حالی که نسخهی اصلیش دو پوشه اونطرفتره. هر بار این اتفاق بیفته، هزینهی هر تغییر بعدی بالاتر میره.
۲. خطاهای پنهان و شرایط مرزی
کد معمولاً در مسیر عادی درسته و در لبهها میشکنه: ورودی خالی، درخواست همزمان، قطعی شبکه، دادهی نامعتبر. خود من روی سایت خودم تجربهش کردم: بخش بکاند و بخش فرانتاند هر کدوم جدا کاملاً سالم بودن، ولی چون فرانتاند داده رو از آدرس عمومی سایت میگرفت، روزی که اینترنت سرور قطع شد کل سایت خطا داد. هیچ قطعه کدی بهتنهایی باگ نداشت؛ باگ توی مرز بین دو بخش بود. این نوع خطا رو فقط کسی پیدا میکنه که کل سیستم رو در ذهن داره.
۳. تست و اثبات درستی
توضیح قانعکنندهی مدل دربارهی کدی که نوشته، یا یه بار اجرای موفق، جای تست رو نمیگیره. کدی که «به نظر درست میاد» خطرناکتر از کدیه که آشکارا خراب است، چون کسی دنبال ایرادش نمیگرده. تست خودکار، بهخصوص برای سناریوهای شکست، تنها راه مطمئن شدنه.
۴. امنیت و حریم خصوصی
کد تولیدشده همون الگوهایی رو تکرار میکنه که در دادههای آموزشی زیاد دیده: از جمله الگوهای ناامن. اعتبارسنجی ناقص ورودی، چک نکردن مالکیت داده قبل از برگرداندنش، کلید API که مستقیم توی کد نوشته شده، یا لاگی که اطلاعات حساس کاربر رو ذخیره میکنه. هر خروجیای که به دادهی کاربر یا دسترسیها دست میزنه، باید از نظر امنیتی جدا بررسی بشه.
۵. نگهداری و توسعهپذیری
کدی که امروز کار میکنه، ممکنه فردا تغییر دادنش سخت باشه. وقتی تولید کد تقریباً هزینهای نداره، وسوسهی اضافه کردن کد بیشتر هم زیاد میشه؛ ولی هر خط کد، خطی است که باید خونده، فهمیده و نگهداری بشه. نامگذاری درست، حذف تکرار و پیروی از قراردادهای پروژه حالا مهمتر از قبلاند.
پژوهشها چی میگن؟
اینجا جاییه که بحث از نظر شخصی به داده میرسه. سه پژوهش معتبر، سه تصویر متفاوت میدن:
افزایش بهرهوری، در شرایط مشخص. یه مقالهی منتشرشده در Management Science نتایج سه آزمایش میدانی تصادفی در مایکروسافت، اکسنچر و یه شرکت بزرگ دیگه رو روی ۴٬۸۶۷ توسعهدهنده ترکیب کرده. توسعهدهندههایی که به ابزار تکمیل خودکار کد (GitHub Copilot) دسترسی داشتن، بهطور میانگین حدود ۲۶٪ وظیفهی بیشتری تکمیل کردن؛ و توسعهدهندههای کمتجربهتر بیشترین سود رو بردن. این آزمایشها بین سالهای ۲۰۲۲ تا ۲۰۲۴ و با ابزارهای همون دوره انجام شدن.
کندتر، در حالی که فکر میکردن سریعترن. در آزمایش تصادفی METR (۲۰۲۵)، ۱۶ توسعهدهندهی باتجربه روی ۲۴۶ وظیفهی واقعی در پروژههای متنبازی کار کردن که خودشون سالها روشون فعال بودن. وقتی ابزارهای هوش مصنوعیِ اوایل ۲۰۲۵ مجاز بود، کارها بهطور میانگین ۱۹٪ بیشتر طول کشید؛ در حالی که خود شرکتکنندهها بعد از آزمایش فکر میکردن حدود ۲۰٪ سریعتر بودن.
تقویتکننده، نه راهحل. گزارش DORA ۲۰۲۵ گوگل، بر پایهی نظرسنجی از نزدیک به ۵٬۰۰۰ متخصص فناوری، نتیجه میگیره که هوش مصنوعی بیشتر نقش تقویتکننده داره: تیمهایی که فرایند و زیرساخت خوبی دارن رو قویتر میکنه و مشکلات تیمهای ضعیف رو بزرگتر.
این نتایج با هم تناقض ندارن؛ با هم یه حرف میزنن. چند نکته از کنار هم گذاشتنشون:
- تعداد خطوط کد یا تعداد وظیفهی بستهشده، معیار کامل بهرهوری نیست. سرعت تکمیل یه کار با کیفیت و پایداری محصول یکی نیست.
- نوع کار مهمه. کمک گرفتن روی یه کد آشنا و پیچیده با کمک گرفتن برای شروع یه کار تازه فرق داره.
- حس سرعت با سرعت واقعی فرق داره. شکاف بین تصور و اندازهگیری در آزمایش METR، دلیل خوبیه که به جای حس، اندازه بگیریم.
- نتیجهی یه آزمایش رو نمیشه بدون بررسی به همه تعمیم داد. ابزارها هم خیلی سریع عوض میشن؛ عدد امروز ممکنه سال بعد معتبر نباشه.
گردشکار درست برای ساخت نرمافزار با هوش مصنوعی
بهجای توصیهی کلی «کد رو بررسی کن»، این فرایندیه که در عمل جواب میده:
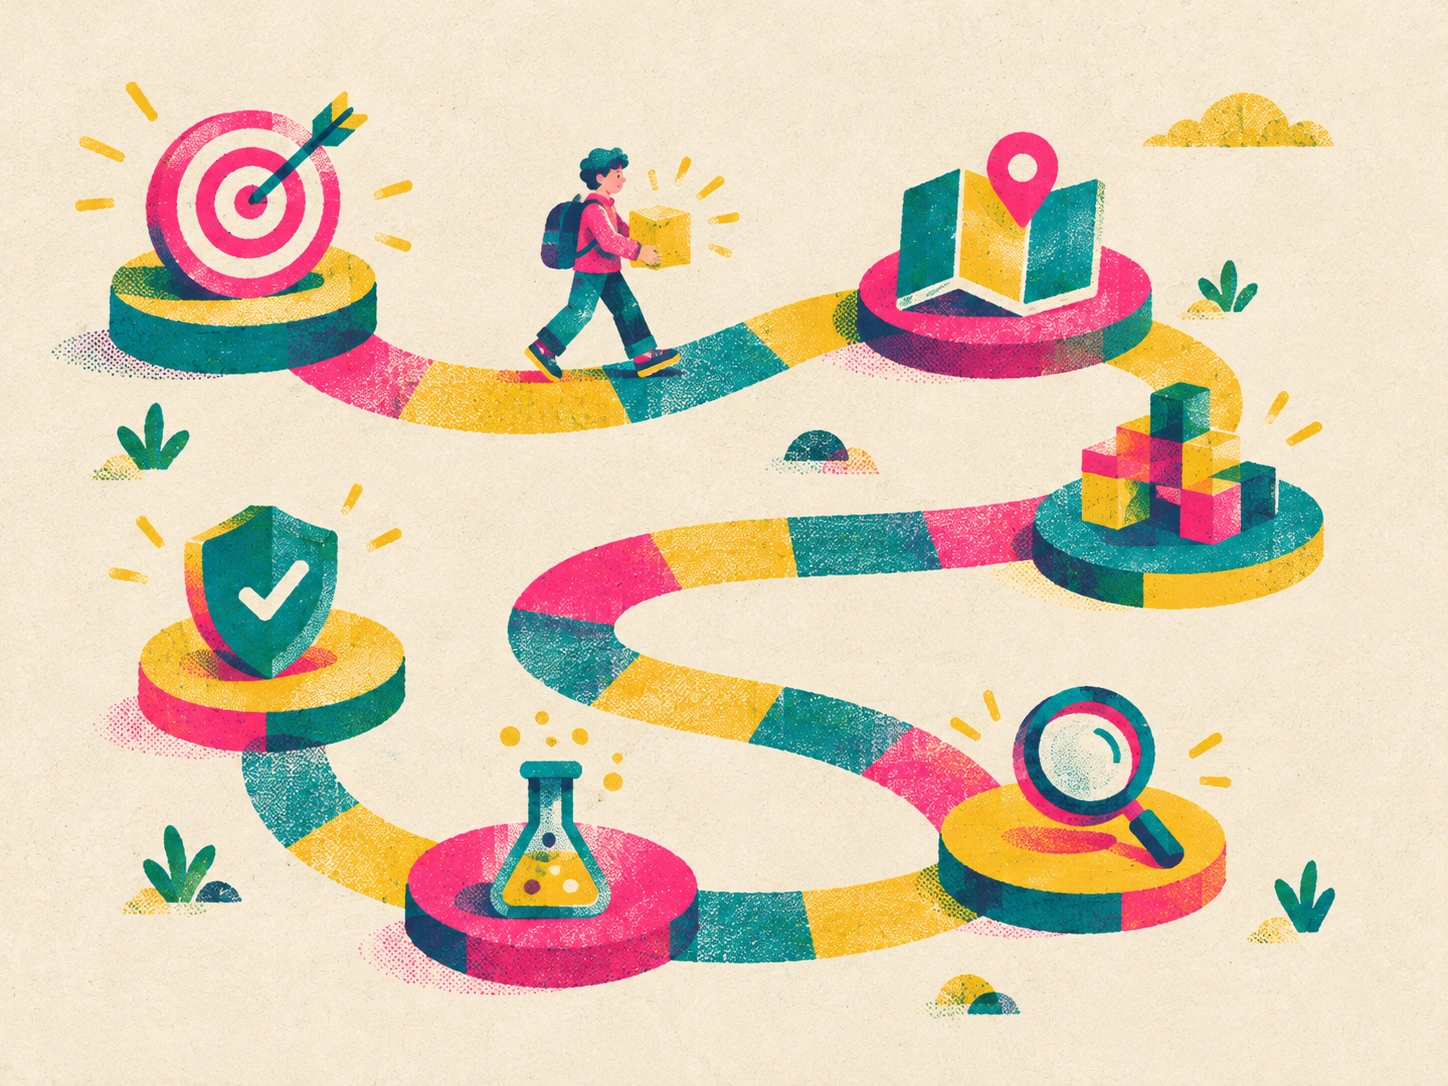
- مسئله رو تعریف کن. نیازمندیها، محدودیتها و معیار پذیرش رو قبل از اولین درخواست بنویس: «کِی میگیم این کار تموم شده؟»
- اول نقشه، بعد کد. از ابزار بخواه راهحل و مراحل رو توضیح بده و همونجا بررسیش کن. اصلاح یه نقشهی اشتباه خیلی ارزونتر از اصلاح هزار خط کد اشتباهه.
- تغییرات کوچیک. قابلیت رو به قدمهایی بشکن که هر کدوم جدا قابل بررسی و تست باشن.
- تغییرات رو بخون، نه فقط نتیجه رو. کدوم فایلها عوض شدن؟ چه وابستگی تازهای اضافه شد؟ چه تصمیم فنیای بیصدا گرفته شد؟
- تست کن، بهخصوص مسیرهای شکست. تستهای موجود رو اجرا کن و برای شرایط مرزی سناریو بنویس.
- قبل از انتشار، امنیت و برگشتپذیری رو چک کن. تنظیمات حساس، دسترسیها، لاگ خطا، و اینکه اگه مشکلی پیش اومد، چطور به نسخهی قبل برمیگردی.
این فرایند به این معنی نیست که باید همهی کدها رو خودت خطبهخط بنویسی یا بخونی. هدف، کنترل نتیجه و تصمیمهای پرریسکه، نه کنار گذاشتن اتوماسیون. هرچی کار پرریسکتر (پول، دادهی کاربر، دسترسیها)، بررسی دقیقتر.
نقش برنامهنویس در حال تغییره
ارزش یه مهندس نرمافزار هیچوقت در سرعت تایپ یا حفظ کردن نحو زبان نبود، ولی تا وقتی نوشتن کد کند بود، این دو تا با هم قاطی میشدن. حالا که تولید کد ارزون شده، چیزهایی که همیشه مهم بودن واضحتر دیده میشن: فهمیدن مسئلهی واقعی، تشخیص اینکه خروجی کجا اشتباهه، اولویتبندی، انتخاب بین راهحلهایی که هر کدوم هزینهای دارن، و مسئولیت نتیجه.
با این حال، نتیجهی درست این نیست که «دیگه لازم نیست کد بلد باشی». برعکس: برای اینکه بتونی خروجی یه ابزار رو ارزیابی کنی، باید کد رو بخونی، دیباگ کنی و رفتار سیستم رو بفهمی. کسی که اینها رو بلد نیست، نمیتونه تشخیص بده ابزار کجا اشتباه کرده؛ فقط سریعتر اشتباه تحویل میده.
جمعبندی: کد بیشتر، لزوماً نرمافزار بهتر نیست
ساخت نرمافزار هنوز سخته، چون نوشتن کد همیشه فقط بخشی از حل مسئله بوده. هوش مصنوعی اون بخش رو بهطرز چشمگیری سریع کرده، و همین باعث شده بقیهی بخشها (طراحی، یکپارچهسازی، تست، امنیت، نگهداری) بیشتر از همیشه به چشم بیان.
مزیت رقابتی یه توسعهدهنده در سالهای آینده صرفاً استفاده از هوش مصنوعی نیست؛ همه از اون استفاده میکنن. مزیت واقعی، توانایی هدایت اون به سمت نتیجهایه که درست، قابل اعتماد و قابل نگهداری باشه.